Plataforma editorial com IA · Python e Next.js

The Moneta Post

Portal de notícias em três edições (Brasil, América Latina e internacional) produzido por um pipeline editorial automatizado: coleta de fontes, síntese por modelos de linguagem, verificação independente, publicação e distribuição em redes sociais, vídeo e newsletter, com supervisão humana por auditoria.

Papel
Fundador · arquitetura, desenvolvimento e operação
Organização e período
The Moneta Post · mai/2026 – atual
Plataformas
Web (site público em 3 idiomas) · Painel administrativo · Pipeline de dados e IA · Redes sociais e newsletter
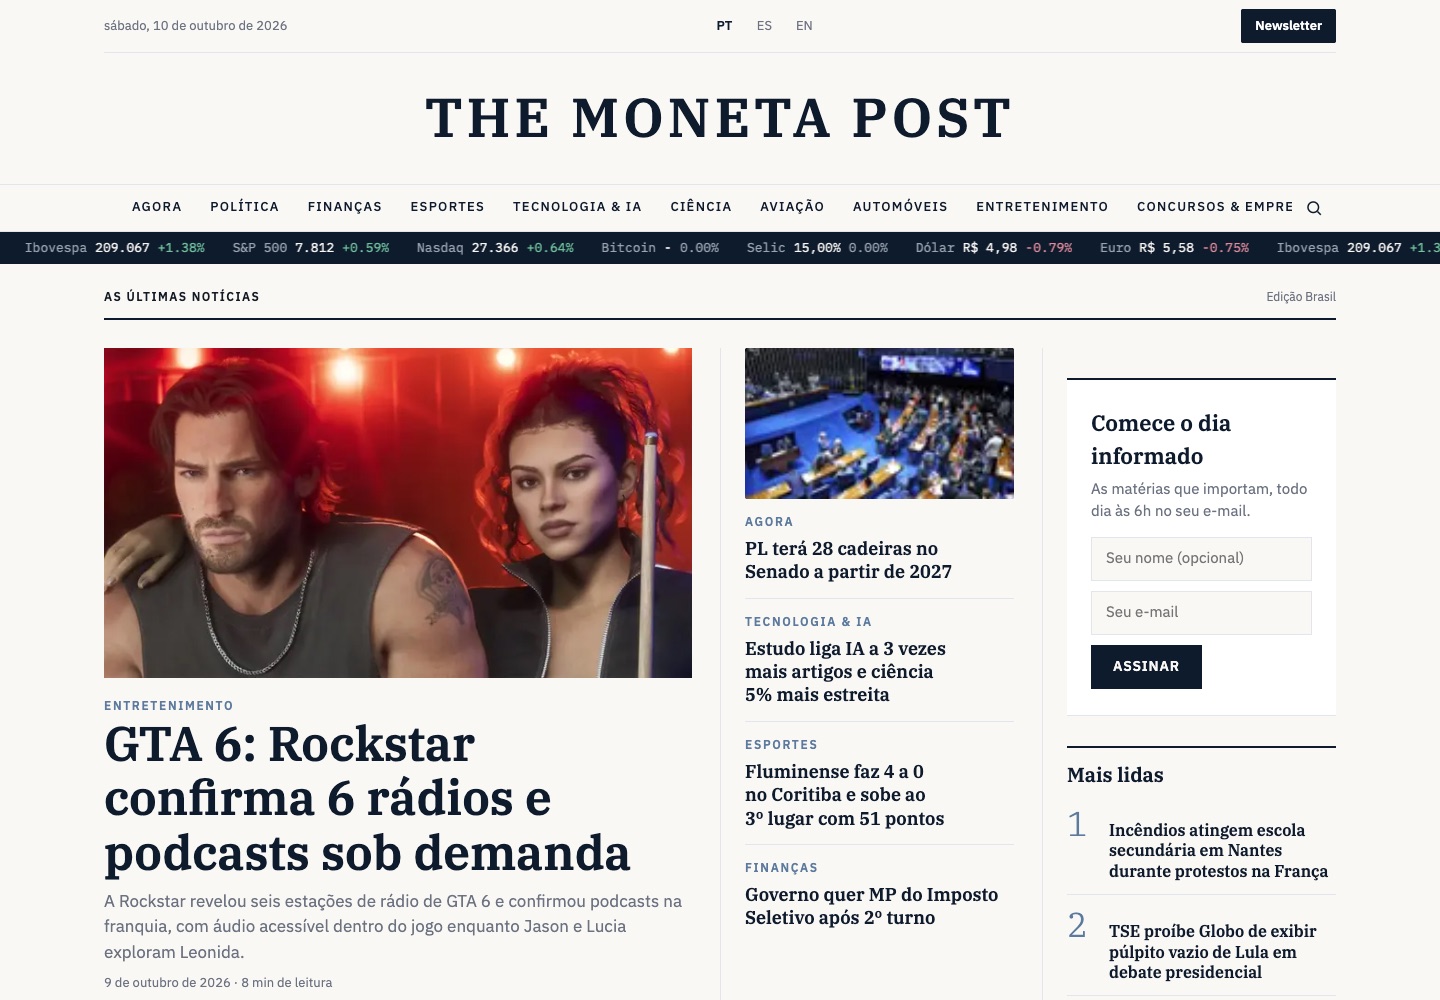
Página inicial da edição Brasil do The Moneta Post, com seletor de idioma PT/ES/EN, menu de editorias, faixa de cotações e destaques do dia
Edição Brasil

01 / Contexto

História e problema

Para quem
Leitores de notícias em português, espanhol e inglês, com edições independentes para Brasil, América Latina e público internacional, nas editorias de finanças, política, esportes, tecnologia, ciência, aviação, automóveis, entretenimento e empregos.
Problema
Manter um jornal diário em três idiomas exige coletar e cruzar fontes, escrever, checar, revisar, ilustrar e distribuir em vários canais a cada hora. Feito à mão, isso demanda uma redação inteira; feito com IA sem controle, gera erro factual, texto inventado e custo imprevisível. O projeto busca automatizar a produção mantendo portões de qualidade, rastreabilidade de custo e supervisão humana.
Restrições
Operação enxuta, sem equipe de redação; dependência de provedores externos de IA e de APIs de redes sociais com cotas, créditos e aprovações próprias; conteúdo sensível (finanças, saúde, óbitos) exige fonte oficial antes de publicar.
  1. mai/2026

    Início do projeto e definição da especificação do produto.

  2. jul/2026

    Repositório iniciado; pipeline central (coleta RSS, agrupamento por similaridade com pgvector, extração de fatos, síntese e verificação com portões) e site em Next.js.

  3. jul/2026

    Primeiras integrações de distribuição (X e newsletter), primeiro vídeo vertical automático com narração e legendas, e painel administrativo.

  4. ago/2026

    Newsletter diária por edição, resumo diário em vídeo horizontal e reorganização das editorias.

  5. set/2026

    Agendador editorial, seleção de modelo por avaliação de qualidade e custo (Jev) e atualização para Next.js 16 e React 19.

  6. out/2026

    Reestruturação editorial com novas editorias e revisão de língua obrigatória antes de gravar cada matéria.

02 / Papel

Minha responsabilidade

Liderança e direção

  • Defini o produto, a linha editorial, as regras de estilo e neutralidade e os critérios de conteúdo sensível que o sistema aplica.
  • Estruturei o plano de produção em etapas com portões de aprovação, nos quais nenhuma etapa avança sem minha validação.
  • Decidi a arquitetura de IA multi-provedor, as regras de escolha de modelo (qualidade parecida, vence o mais barato) e os limites de custo.
  • Defini as políticas de operação: módulos novos atrás de feature flag com ativação aprovada, backup antes de mudança em produção e reativação controlada após falhas de crédito.

Execução técnica direta

  • Concebi e construí a plataforma completa: site público, painel administrativo, API e pipeline editorial.
  • Implementei o roteamento de modelos com cadeia de fallback por etapa, teto de custo e verificador em provedor diferente do autor.
  • Integrei a distribuição em Instagram, Facebook, Threads, X, YouTube e TikTok, além da newsletter com Listmonk e Resend.
  • Implementei a geração automática de vídeos (narração, legendas sincronizadas e montagem) e carrosséis por edição.
  • Opero a infraestrutura em servidor próprio: deploy, rotinas agendadas, monitoramento, backup e segurança.

Trabalho da equipe

  • Equipe de apoio sob minha coordenação, com nomes preservados.

03 / Arquitetura

Arquitetura documentada

Monorepo com um pipeline Python que coleta, escreve, verifica e distribui conteúdo, uma API FastAPI para o painel, e um site Next.js que lê as matérias publicadas. Toda chamada a modelo de linguagem passa por um roteador único, que aplica fallback, teto de custo e a escolha de modelo baseada em avaliação. A produção é dirigida por rotinas agendadas que respeitam o fuso de cada edição.

Arquitetura do The Moneta Post
  1. Leitores e canais
    • Site pt/es/en
    • Redes sociais
    • Newsletter
  2. Aplicações
    • Site Next.js
    • Painel administrativo
    • API FastAPI
  3. Pipeline editorial
    • Coleta e agrupamento
    • Síntese e verificação
    • Mídia e distribuição
  4. Orquestração de IA
    • Roteador de modelos
    • Avaliação (Jev)
    • Teto de custo
  5. Dados e operação
    • PostgreSQL + pgvector
    • Redis e PgBouncer
    • Cron, Docker, nginx

Camadas e tecnologias

Site público
Next.js 16, React 19 e TypeScript estrito, com rotas por idioma e editoria, busca, RSS, sitemap de notícias e consentimento de medição de audiência. Cores e tipografia vêm de um pacote de tokens; o CI barra cor fixa fora dele.
Painel e API
API em FastAPI com Pydantic v2, autenticação e seis papéis com permissões por método e rota (entre eles proprietário, administrador, editor, leitor, publicidade e financeiro). O painel concentra matérias, agenda editorial, redes, newsletter, desempenho de modelos e custos.
Pipeline editorial
Python 3.12. Coleta RSS (feedparser, trafilatura), agrupamento de pautas por embeddings em pgvector, pontuação de pauta, extração de fatos, síntese, verificação independente, revisão de língua e publicação. Prompts versionados em arquivos, nunca no código.
Orquestração de IA
Roteador único para OpenAI, Anthropic e Google, com cadeia de fallback por etapa, até 3 tentativas com espera crescente, saída sempre em JSON validado e teto diário de custo por etapa. O verificador nunca usa o provedor que escreveu a matéria. A ordem da cadeia é ajustada por avaliação contínua de qualidade, engajamento e preço.
Mídia
Vídeos verticais e horizontais montados com Remotion e ffmpeg; narração por TTS da OpenAI ou do Google, escolhida pela mesma lógica de avaliação; legendas com tempo por palavra via Whisper, que também valida se o áudio corresponde ao roteiro. Carrosséis e artes gerados com Pillow.
Distribuição
Publicação em Instagram, Facebook e Threads (APIs da Meta), X, YouTube e TikTok, com fila de rascunhos, reenvio controlado e descarte de rascunhos vencidos. Newsletter diária por edição com Listmonk e envio pelo Resend, incluindo tratamento de devoluções.
Dados
PostgreSQL 16 com pgvector, PgBouncer e Redis. Migrations Alembic reversíveis; tabelas com identificação de tenant. Decisões de modelo, auditorias de qualidade e custos de API ficam registrados para análise.
Infraestrutura e operação
Servidor Linux próprio com Docker Compose para banco, cache, cofre de segredos (Vaultwarden) e monitoramento (Uptime Kuma); API e site como serviços systemd atrás de nginx e Cloudflare. Produção dirigida por cron, com janelas de horário calculadas no fuso de cada edição dentro dos jobs. Ambiente de staging, scripts de deploy e rollback, rotina de backup com ensaio de restauração e Sentry.
Qualidade
GitHub Actions em todo push: gitleaks (segredo em commit derruba o build), ruff, pytest, verificação de cor fixa e regra de escrita. Testes espelham os módulos, incluindo roteador, verificador, portões e aprendizado de modelo. Mudança de prompt exige teste de regressão de estilo.
04 / Decisões

Decisões técnicas e compromissos

Ponto único de chamada de IA com verificador independente

Problema
Várias etapas usam modelos de linguagem, e cada provedor pode ficar sem crédito, recusar ou devolver JSON malformado. Além disso, um modelo que revisa o próprio texto tende a aprovar os próprios erros.
Decisão
Centralizei todas as chamadas em um roteador com cadeia de modelos por etapa, tentativas com espera crescente, reparo de JSON e teto de custo. A verificação exclui o provedor que escreveu a matéria e empurra para o fim da fila o provedor da síntese, para que uma indisponibilidade não mascare a alternativa viável.
Motivo
Um único ponto permite trocar modelos, medir custo e aplicar regras de independência sem espalhar lógica pelo código.
Compromisso
Mais complexidade no roteador e dependência de pelo menos dois provedores ativos para verificar. Os embeddings ficaram presos a um único provedor, porque trocar quebraria a compatibilidade dos vetores já gravados.
Aprendizado
Uma falta de crédito em agosto de 2026 parou a produção justamente pelos embeddings, sem alarme. A resposta foi um vigilante de crédito que detecta a volta do saldo e religa o ciclo.

Escolha de modelo por avaliação de qualidade, engajamento e preço

Problema
Fixar um modelo por etapa ignora que a qualidade varia por idioma e tema, e que modelos novos e mais baratos surgem a cada mês.
Decisão
Integrei o Jev (TypeSafe) como avaliador das peças publicadas. A recompensa de cada modelo combina 40% da nota de qualidade e 60% do engajamento real em 72 horas. O melhor vira o primeiro da cadeia; entre modelos com recompensa até 5 pontos abaixo do líder, vence o mais barato. Parte das chamadas (15%, ou 30% com candidatos de poucas amostras) explora alternativas. Uma prova semanal define quais modelos podem disputar, e modelos com reprovação de 70% ou mais (mínimo de 30 matérias no idioma) vão para o fim da fila.
Motivo
Transforma a escolha de modelo em decisão baseada em dados e auditável, com o custo como critério explícito.
Compromisso
A exploração publica parte do conteúdo com modelos menos testados, mitigada pelos mesmos portões de verificação; o engajamento demora 72 horas para amadurecer.
Aprendizado
Qualquer falha no aprendizado preserva a cadeia original: a camada inteligente nunca pode derrubar a produção.

Portões determinísticos acima da nota do juiz

Problema
Uma nota única do verificador não separa erro factual grave de ressalva de estilo. Com barra alta, o sistema descartava matérias sem risco; com barra baixa, arriscava publicar erro em tema sensível.
Decisão
Separei travas que barram sempre (tema sensível sem fonte oficial, divergência entre fontes sem resolução, recusa do modelo) de critérios ajustáveis. Problema grave apontado pelo juiz gera uma reescrita focada nos trechos indicados e nova auditoria; se persistir, a matéria é descartada. Estilo proibido e vazamento de texto interno são checados por código antes do juiz.
Motivo
O que é inegociável fica fora do alcance da calibração; o limiar de publicação pode ser ajustado com base nos dados de rejeição sem afrouxar a proteção factual.
Compromisso
O limiar foi recalibrado várias vezes (90, 82, 88 e depois 80, com publicação a partir de 70 quando não há problema grave), sempre documentado no código com a análise que motivou a mudança.

Política de falha para integrações externas

Problema
APIs de redes sociais impõem cotas diárias, limites de requisição e erros passageiros. Repetir sem critério duplica posts; não repetir perde publicações; repetir tarde demais publica notícia velha.
Decisão
Posts que falham ficam como rascunho e são reenviados por uma rotina separada, que só toca rascunhos com mais de 20 minutos (para não disputar um envio em andamento) e os descarta após 24 horas, ou 48 horas no YouTube, cuja cota zera em outro fuso. Ao detectar cota estourada, a rodada para de chamar o YouTube. Ao voltar o crédito de IA, o que estava parado na distribuição é descartado antes de religar.
Motivo
Garante que nenhum post seja duplicado e que conteúdo vencido não seja publicado, mantendo o máximo de entregas possível.
Compromisso
Alguns posts são descartados sem sair quando a falha dura mais que a janela; o TikTok ficou fora do reenvio automático por exigir consentimento a cada envio.
Aprendizado
A guarda de 20 minutos nasceu de um incidente real de post duplicado no Instagram, causado por duas rotinas reenviando o mesmo rascunho.

Implantar não é ativar

Problema
Um pipeline que publica sozinho transforma qualquer bug em conteúdo público em poucos minutos.
Decisão
Módulos novos entram no código atrás de feature flag; a ativação é uma decisão separada, registrada e aprovada por mim. O plano de produção avança por etapas com portões assinados, e mudanças em produção exigem backup do banco antes.
Motivo
Separa entrega técnica de risco editorial e permite desligar uma função sem novo deploy.
Compromisso
Mais configuração para gerenciar e um passo extra entre a entrega técnica e o uso.

05 / Funcionamento

Fluxo e modelo

Do feed à publicação (fluxo com dados sintéticos)

  1. A coleta lê os feeds RSS das fontes da edição e agrupa notícias parecidas por similaridade de embeddings.
  2. O agendador escolhe a pauta do horário pela editoria do horário e pela pontuação do grupo, por exemplo uma decisão de juros com três veículos confirmando.
  3. Um modelo extrai os fatos e outro escreve a matéria no idioma da edição, escolhido pela avaliação de qualidade e custo.
  4. O verificador, em outro provedor, audita fatos, neutralidade e risco; problema grave gera uma reescrita e nova auditoria.
  5. A revisão de língua corrige ortografia e pontuação e é descartada se alterar números, nomes ou parágrafos.
  6. A matéria é publicada no site; em seguida saem carrossel, vídeo com narração e legendas, posts nas redes e a entrada na newsletter do dia seguinte.

Modelo lógico simplificado

Matéria
edição, editoria, título, texto, status (fila, publicada, descartada), modelo usado, nota da verificação
Verificação
matéria, juiz (provedor e modelo), nota, problemas por gravidade, decisão (publicar, regenerar, descartar)
Decisão de modelo
tarefa, idioma, cadeia original, cadeia efetiva, motivo (melhor recompensa, explorando), resultado
Métrica de modelo
tarefa, idioma ou tema, provedor, modelo, recompensa média, amostras
Post social
matéria, rede, edição, status (rascunho, publicado, erro, descartado), identificador externo

06 / Evidências

Resultados e próximos passos

Resultados e evidências

  • Site público nas edições Brasil, América Latina e internacional, com matérias publicadas pelo pipeline automatizado.
  • Repositório com cerca de 700 commits entre julho e outubro de 2026, 77 migrations de banco e mais de 200 arquivos de teste executados no CI.
  • Distribuição integrada em seis redes sociais e newsletter diária por edição, com vídeos e carrosséis gerados automaticamente.
  • Escolha de modelo e custo de IA rastreáveis: cada decisão de roteamento e cada custo de chamada ficam registrados no banco.

Próximos passos

  • A qualidade editorial depende dos portões e da avaliação automática; a supervisão humana é por auditoria e amostragem, não matéria a matéria.
  • Os embeddings dependem de um único provedor; trocar exige reprocessar os vetores gravados.
  • A operação roda em um único servidor; alta disponibilidade e separação de ambientes de processamento são próximos passos.

07 / Telas

Galeria

Próximo estudo de caso

Presto PDF
Todos os projetos